
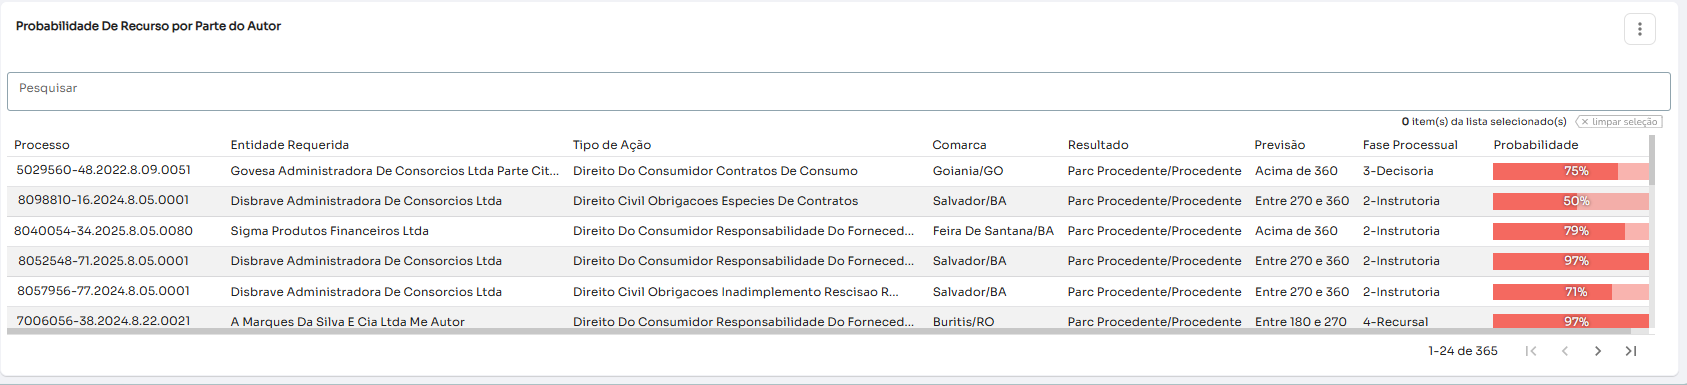
O componente Probabilidade de Recurso por Parte do Autor apresenta uma visão individualizada dos processos analisados, destacando a probabilidade estimada de interposição de recurso pela parte autora após a prolação da sentença.
As estimativas são geradas por modelos de inteligência artificial treinados com base no histórico da carteira e em processos semelhantes, permitindo identificar casos com maior propensão à continuidade da discussão judicial em instâncias recursais.
O objetivo é apoiar análises estratégicas e operacionais, auxiliando na priorização de processos e na avaliação de possíveis desdobramentos processuais.
📊 Como interpretar as informações
O componente apresenta as seguintes informações para cada processo analisado:
📄 Processo: número do processo analisado;
🏢 Entidade Requerida: parte demandada identificada no processo;
📋 Tipo de Ação: classificação da ação judicial;
📍 Comarca: localidade de tramitação do processo;
⚖️ Resultado Previsto: desfecho mais provável para o processo, podendo ser:
- ❌ Improcedente/Extinto;
- ✅ Parcialmente Procedente/Procedente.
📅 Previsão: intervalo estimado, em dias, para ocorrência da sentença;
📈 Probabilidade: percentual que representa a chance estimada de interposição de recurso pela parte autora.
Cada linha corresponde a um processo específico, permitindo consultar individualmente as previsões geradas pelo modelo.
🤖 Como a estimativa é calculada
As previsões são produzidas por modelos de aprendizado de máquina, treinados com base no histórico processual da carteira.
Para gerar as estimativas, são considerados diversos fatores, entre eles:
📋 Informações da capa do processo;
🔄 Movimentações processuais;
⚖️ Decisões judiciais;
📊 Histórico de recursos interpostos em processos semelhantes;
📚 Comportamento processual observado em casos com características equivalentes.
O algoritmo é personalizado para cada cliente, identificando padrões relevantes e atribuindo maior peso aos fatores que demonstram maior influência na probabilidade de interposição de recursos.
Além disso, os modelos passam por validações contínuas para monitorar a qualidade estatística das previsões.
🔍 Pesquisa e navegação
O componente disponibiliza recursos que facilitam a consulta das informações:
🔎 Pesquisar: permite localizar rapidamente um processo, comarca, resultado previsto ou entidade requerida.
Esse recurso facilita a identificação de casos específicos dentro da base analisada.
📚 Origem das informações
As análises são realizadas com base nos dados processuais capturados pela plataforma e nas informações públicas disponibilizadas pelos tribunais.
A probabilidade apresentada é calculada considerando centenas de variáveis estatísticas observadas em processos semelhantes e no histórico da carteira.
As previsões são constantemente atualizadas à medida que novos dados processuais se tornam disponíveis.
🎯 Aplicações práticas
Este componente pode ser utilizado para:
⚖️ Identificar processos com maior probabilidade de continuidade na fase recursal;
📊 Priorizar análises em casos com maior potencial de recurso;
📈 Apoiar estimativas de duração e complexidade da carteira;
📋 Auxiliar no planejamento de estratégias processuais;
🔍 Antecipar possíveis aumentos de volume em instâncias recursais;
🏢 Apoiar a gestão e segmentação dos processos por nível de risco recursal.
🧩 Como analisar os resultados
Ao interpretar as informações, recomenda-se observar:
📈 Os processos que apresentam maiores probabilidades de recurso;
⚖️ A relação entre o resultado previsto e a probabilidade recursal;
📅 O prazo estimado para sentença associado a cada caso;
📊 A concentração de processos com elevado potencial de recurso;
📋 Os padrões identificados entre processos semelhantes.
A análise conjunta dessas informações permite antecipar comportamentos processuais e apoiar o planejamento da atuação jurídica.
⚠️ Considerações importantes
📁 O componente considera processos analisados pelos modelos preditivos da plataforma.
🤖 As informações apresentadas são estimativas estatísticas geradas por modelos de aprendizado de máquina.
📊 A probabilidade de recurso não representa garantia de que haverá efetivamente a interposição de recurso.
⚖️ As previsões são baseadas em padrões históricos identificados em processos semelhantes e podem ser impactadas por eventos futuros não observados pelo modelo.
📈 Quanto maior a quantidade de dados históricos disponíveis, maior tende a ser a robustez estatística das estimativas.
🔄 Novas movimentações processuais, decisões judiciais ou alterações relevantes no processo podem influenciar as previsões apresentadas.
📋 As informações devem ser utilizadas como apoio à análise e à tomada de decisão, não substituindo a avaliação técnica do caso concreto.
🤝 Suporte e Customer Success
Para dúvidas estratégicas sobre o uso da plataforma e seus módulos, conte com o time de Customer Success.
Para questões operacionais entre em contato com o Suporte pelo e-mail: suporte@deeplegal.com.br.
Importante:
Nenhuma aplicação da Deep Legal substitui o acompanhamento e a atuação do patrono da causa.